株式会社ヘンリー エンジニアブログ

株式会社ヘンリーのエンジニアが技術情報を発信します

あなたもわたしも OpenTelemetry Collector

はじめに

ヘンリーで SRE をしている galoitsu です。

ヘンリーが提供するレセコン一体型電子カルテ Henry はオブザーバビリティバックエンドに Honeycomb を採用しています。 AWS 側*1のアプリケーションは ECS で動き、トレースは OpenTelemetry Collector を経由して Honeycomb に送られます。 collector はアプリと同じタスクのサイドカーではなく、独立した ECS サービスとして動かしています。

[アプリの ECS タスク] --OTLP--> [collector の ECS タスク] --> Honeycomb

トレースのスパンには、それがどこで動いていたかを表す属性を付与するようにしています。 ECS なら aws.ecs.task.arnaws.ecs.task.family などがそれに当たり、タスク単位の調査・分析に活用でき...るはずでしたが、その aws.ecs.* にアプリの ECS タスクではなく collector 自身の ECS タスクの情報が付与されていました。

原因や修正方法やその判断などを残していきます。

何が起きた?どう困った?

たとえば aws.ecs.task.family 属性を Honeycomb で確認するとスパンのを見ると、すべてのアプリのスパンで aws.ecs.task.family の値が collector のタスクファミリーになっていました。 Henry のアプリ側では service.name という属性を付与しているいるため、これを活用することでアプリの区別はつきますが、タスクの区別まではできません。 これにより、「特定のタスクだけレイテンシーが伸びていないか」「直前に入れ替わったタスクにエラーが偏っていないか」などといったタスクに強く関連する問いに対して、トレースを基に答えられない状態でした。

なぜ起きた?

collector の traces パイプラインには、resourcedetection プロセッサーの ECS detector を設定していました。

processors:
  resourcedetection/ecs:
    detectors: [ecs]
    timeout: 2s
    override: false

この detector は、自分のプロセスから見える環境変数 ECS_CONTAINER_METADATA_URI_V4 からタスク情報を取得します。 つまり、collector がアプリと同じタスクのサイドカーなら読み取った値はアプリのタスクと一致しますが、独立した ECS サービスなら collector 自身のタスクになります。 そして collector を通過するすべてのスパンにその値を付与しようとします。

また、override: false も設定していました。

この設定は、スパンがすでに同名の属性を持っているならそれを尊重し、持っていないならフォールバックとして detector が取得した値を付与します。

これらの設定により、 アプリ側の SDK で aws.ecs.* を付与していれば、それがそのまま Honeycomb に送信されるはずでした。 しかし Honeycomb でスパンの aws.ecs.* を見ると、すべてのアプリで collector 自身の ECS タスクの情報になっていました。そう...

誰も... aws.ecs.* を付与していないのである!!!

つまるところ原因は以下です。

  • Henry のすべてのアプリが、アプリ側の SDK で aws.ecs.* を付与していなかった
  • アプリ側の SDK で aws.ecs.* が付与されていなかったため、 collector 側のフォールバックが常に効いてしまっていた
    • detector は collector から見て正しい ECS タスクの情報を代わりに埋めてくれていた(が、それは適切な値ではない)

修正方法は?

原因がわかれば修正方法はシンプルで、アプリ側の SDK で適切な aws.ecs.* を付与してあげればよいだけです。アプリ側の SDK で ECS resource detector を有効にすれば、適切な aws.ecs.* を付与することができ、override: false による collector のフォールバックは発火しなくなります。

環境変数で有効化する

Henry ではバックエンドの言語として Kotlin と TypeScript の2種類を使用しているので、それぞれの設定を変更して修正していきました。 コードの変更で修正することもできそうでしたが、 The Twelve-Factor App (日本語訳) に則り設定は環境変数で制御できるほうが望ましいと判断しました。

Kotlin(JVM)

AWS resource provider がバンドルされていますが、デフォルトで無効です。環境変数 OTEL_RESOURCE_PROVIDERS_AWS_ENABLED を足すだけで有効になるのでこれを有効にしました。

OTEL_RESOURCE_PROVIDERS_AWS_ENABLED=true

TypeScript(Node.js)

こちらにも似た役目の環境変数 OTEL_NODE_RESOURCE_DETECTORS があります。

OTEL_NODE_RESOURCE_DETECTORS=aws,env

ところが、これを足しても属性は増えませんでした。 この環境変数を解釈するのは SDK 本体ではなく、@opentelemetry/auto-instrumentations-node の関数 getResourceDetectors() です。 Henry の TypeScript アプリケーションでは detector を自前で組み立てており、環境変数を読む関数 getResourceDetectors() を通らない形になっていました。

// 変更前: envDetector だけを直接渡している
.merge(detectResources({ detectors: [envDetector] }))

// 変更後: 有効にする detector を(コードではなく)環境変数 `OTEL_NODE_RESOURCE_DETECTORS` で制御できる
.merge(detectResources({ detectors: getResourceDetectors() }))

なお、この状態で環境変数を未設定のままにすると

OTEL_NODE_RESOURCE_DETECTORS=all

と同等になり、GCP、Azure、Alibaba Cloud など他の detector まで動くようになりますが、明示的に指定しておくのが無難だと判断して aws,env を指定しています。(ゼロコード計装の構成 | OpenTelemetry

仲間はずれの aws.ecs.task.id も修正してあげる

さて、これまでの治療により aws.ecs.* の大半は適切に送信されるようになりましたが、aws.ecs.task.id だけは collector の値が残りました。

semconv はこの属性を次のように定めています。( AWS ECS | OpenTelemetry

The ID of a running ECS task. The ID MUST be extracted from task.arn.

ECS のメタデータエンドポイントに ECS タスク ID は存在せず、抽出は実装側の仕事になっています。 そして opentelemetry-js の AwsEcsDetector も opentelemetry-java-contrib の EcsResource も、この抽出を実装していません。

一方で collector 側の ECS detector はこの抽出を実装しています。

(この差分は upstream でも認識されているようですが、実装はされていないようです → たとえば Go での issue は開かれたまま

これにより、アプリ側の SDK では aws.ecs.task.id は付与されず、collector 側はフォールバックとして aws.ecs.task.id を付与するので collector 側の値のままになってしまっていました。

そこで collector 側でタスク ARN から導出するようにしました。

  transform/ecs-task-id:
    error_mode: ignore
    trace_statements:
      - context: resource
        conditions:
          - resource.attributes["aws.ecs.task.arn"] != nil
        statements:
          - set(resource.attributes["aws.ecs.task.id"], resource.attributes["aws.ecs.task.arn"])
          - replace_pattern(resource.attributes["aws.ecs.task.id"], "^.*/", "")

処理としては、ARN の最後のスラッシュ以降を抽出するだけです。 クラスター名を含む新形式のタスク ARN でも、含まない旧形式でも同じ結果になるようになっています。(Access Amazon ECS features with account settings - Amazon Elastic Container Service

最後にフォールバックをなくす

すべてのアプリが aws.ecs.* 属性を付与するようになれば、collector 側の ECS detector によるフォールバックは不要になります。 フォールバックそのものが誤情報を生みうるので、削除しておくのが望ましいと判断しました。

Honeycomb を見てすべてのアプリで aws.ecs.* 属性を付与できていることを確認し、フォールバックを削除しました。

まとめ

今回は、すべてのアプリの aws.ecs.* 属性が OpenTelemetry Collector の ECS タスク情報になってしまっているのを修正しました。 一連の修正を通して、以下の知見を得られました。

  1. collector を独立したサービスとして運用している構成では、collector の resourcedetection はアプリの ECS タスク情報の供給源にならない
    • override: false を付けていても、そもそもアプリが属性を送っていなければ collector 自身の値が入ってしまう
    • アプリの実行環境に関する属性はアプリ側で埋めるのが素直でわかりやすい構成になる
  2. TypeScript で OTEL_NODE_RESOURCE_DETECTORS を設定しても効果がないときは、getResourceDetectors() を呼んでいるかを確認してみるのがよい
    • 環境変数を読む主体が SDK 本体ではないため、detector を自前で組み立てている場合には環境変数は無視されてしまう
  3. 誤った値を付与するようなフォールバックは避ける
    • 安全面に倒そうとして設定したフォールバックによって誤った値が付与されてしまうこともある
    • 本当に設定すべきフォールバックなのか、慎重に検討してから設定するべき

ヘンリーは顧客の体験を改善していきたい仲間を絶賛採用しております。オブザーバビリティに投資して調査可能なシステムを育てていきたい方、マイクロサービスの計装を横断的に整えることに関心のある方は気軽にご連絡ください。お待ちしています!

jobs.henry-app.jp

*1:Henry の実行基盤を Google Cloud から AWS に移設しようとしており、現在絶賛移設中です。詳しくは ヘンリーではクラウド基盤の移行プロジェクトを開始していますなぜ AWS 移設をするのか を参照ください。

電子カルテとレセコンをやりつづけたからこそ、広大な領域で大きな価値を探索する勝負ができる

こんにちは。ヘンリーで CTO をしている agatan です。

以前、事業戦略は技術戦略に影響を与えるが、技術戦略もまた事業戦略に影響を与えるべき という記事を書きました。今日はその続きの話をしたいと思います。

社外の方と話していると、「ヘンリーって電子カルテの会社だよね」と言われることがとても多いです。それは間違いではないのですが、私たちが本当にやりたいことは実はもっとスコープの広いことであり、その一手目として今のレセコン*1一体型電子カルテというプロダクトを作ってきました。

そして、この1年ほどで、私たちの製品開発は攻略すべき課題設定そのものが急速に変わりはじめています。私は5年前にヘンリーに入社したのですが、入社を決めたときに思い描いていたことに、ようやく手が届きはじめたという感覚があります。このブログでは、その話を書きたいと思います。

膨大な機能セットとの戦い

レセコン一体型の電子カルテというプロダクトは、とにかく求められる機能セットが膨大です。

病院というのはひとつの会社のようなもので、部署があり、専門職がいて、それぞれがコラボレーションしながら医療を提供しています。私たちヘンリーでは、たとえば GitHub、Slack、Notion、Google Workspace などなどを組み合わせて業務を行っていますが、病院においてはレセコン・電子カルテが業務の基幹であり、ほとんどの業務の中心がレセコン・電子カルテとなっています。

病院が実際に提供している医療行為は多種多様で、そのひとつひとつの運用をカバーすることができる製品になる必要があります。しかもその機能は、診療報酬制度という巨大で複雑なルールの上で、正確に動かなければいけません。

さらに、病院には規模と種類があります。慢性期、回復期、急性期と、対象とする病院の種類が変わっていけば、そこで求められる医療行為も運用も変わり、必要な機能セットもまるごと変わります。新しい市場に挑もうとするたびに、そこで必要な機能が新たに見えてくるので、それをいかに高速・正確に積み上げるかが重要でした。

この勝負においては、速く正確に作り切ること が、そのまま最適戦略になり得ました。もちろんカバーすべき運用が定まったとしても、そのために何をどう作るべきかを見極めること自体は相当に難しく、粒度やスコープの判断は毎回骨が折れるもので、簡単ではありません。が、それでもある程度は「決めて作り切れば前に進める」という構造がありました。以前のブログ記事では、そういったシチュエーションにおいて私が感じていた悩み事を書きました。

dev.henry.jp

このブログ記事を書いたのが1年ちょっと前のことです。この1年の大半は、最速で機能セットを作り切るためにできることを考え続けていました。フォーカスを絞り、ユーザー要求を厳密に精査し、運用を考慮しながらスコープを削り、意思決定の組織としての流速を高める、といったことを考えてきました。

その過程で、開発チーム自身がより積極的に現場に足を運んでアセスメントやヒアリングを重ねるようになり、顧客理解の深さがぐっと上がりましたし、組織の文化が大きく変化してきました。

AIという追い風を最大化したことで、次のステージが見えてきた

この1年で、AIによってコードを書く速度は大きく上がりました。

ヘンリーの課題は「作るべきものが大量に並んでいる」ことだったので、これは非常に大きな追い風でした。作るべきものはある程度見えていて、あとはどれだけ速く、正確に作り切れるかが勝負の支配的な要素だったからです。

しかし、AIによって電子カルテやレセコンを作ること自体が簡単になったわけではありません。病院ごとに提供している医療行為は異なり、現場の運用も異なります。その一つひとつを理解し、臨床業務として自然に使えるものでありながら、診療報酬制度上も正しく動くものにしなければならない。この難しさは、AIが登場しても変わっていません。

変わったのは、その難しさを乗り越えるために発生するオーバーヘッドです。

以前は、一つの機能を作るために、多くのエンジニアが必要でした。診療報酬制度や絡み合う業務フローのために、単体の機能であっても手を加える範囲が広くなりやすく、開発工数が膨らむ傾向にあったためです。制度の知識、現場業務の知識、既存製品の知識、技術の知識が分散していて、誰か一人では判断を前に進めづらい中、人数が増えれば増えるほどコミュニケーションコストは高まり、オーバーヘッドが大きくなっていました。

いまは、1人から3人ほどの小さなチームでも、一つの領域について理解を深め、顧客と話し、何を作るかを決め、実装して検証するところまで進められる場面が増えています。

もちろん、それを可能にしたのは、AIだけではありません。この数年間で、社内には医療制度や病院業務への理解が蓄積され、何をどう作るべきかを正確に意思決定する経験も積むことができましたし、そのナレッジも組織の力になっています。モノレポ化やモジュール分割といった土台の整備、負債の大きかったコンポーネントのリニューアルなど、これまで積み上げてきた投資が効いているのも大きかったかもしれません。

その結果、当初の想定よりかなり前倒しで「作るべきもの」が消化できる可能性が見えてきました。

想定よりかなり前倒せる可能性が見えたことで、製品開発として向き合う事業課題がひとつ解決され、次の課題に向き合うべきタイミングが訪れています。

対象市場への展開に必要な機能セットについて、従来より早く見通しを持てるようになりました。その結果、全リソースを既知の機能開発へ投じ続ける必要がなくなりつつあります。作ることが課題だったフェーズから、何を作れば価値になるのかを探すことが課題になるフェーズへの移行が見込まれ、それに組織的にも適応することが急速に求められているのです。

以前は、目の前に積み上がっているものを崩すことが基本的には最もリターンの大きい行動でした。いまは、「これを作るのが本当に一番いい手なのか」という問いに、まともに向き合える状態になってきています。

そのひとつの発露として、AIネイティブな電子カルテとして成長していくための開発も行い、より大きな価値を提供することができました。既存業務の一部を補助するAIツールを作るのではなく、電子カルテ自体にAIを組み込み、紙へのメモや転記を含む業務フローそのものを組み替えることで、大きな業務効率化を実現できています。これは、基幹システムを持つことが新しい事業の選択肢につながった、重要な実例です。

prtimes.jp

ど真ん中をやりつづけた意味

何を作るのかを探索するのが大事、というのは言ってしまえばどんな事業であっても同じだと思いますが、私はそれでもヘンリーという会社がそのフェーズに入るということには大きな意味があると思っています。その理由は、電子カルテ・レセコンという医療DXのど真ん中、最も難易度の高い場所から入ったことにあります。

電子カルテとレセコンは、病院のど真ん中です。臨床の記録も、会計も、制度対応も、すべてがこのシステムを通ります。そのシステムを作り、導入するということは、すなわち病院で発生するほぼすべての業務に対して接点があり、解像度があるということです。ここを押さえているからこそ解ける病院の課題が、たくさんあるのです。

病院の困りごとは、当然ながら電子カルテの中だけにあるわけではありません。経営もあり、部門ごとの業務もあり、施設の外との連携もある。そして病院のど真ん中を持っている私たちは、それらの課題に対して、他のどこよりも実効性を持ってソリューションを提供できる立場にあります。医療DXという領域そのものの幅の広さやインパクトもあいまって、私たちが探索できる空間そのものは、圧倒的に広いのです。

ヘンリーの本題

私たちが探索しようと考えているのは、電子カルテ・レセコンを作り提供する過程で蓄積された業務理解、データ、顧客接点、制度対応力などのアセットを活かすことで、単独のソリューションより大きな価値を出せる領域です。さまざまな課題に対するソリューションを、電カル・レセコンという基幹システムを媒介にして掛け算になる形で提供することができれば、より大きな価値を社会に生み出せるはずですし、ひいては大きな強みを持った会社になれます。

ヘンリーが提供するソリューション群が互いに相乗効果を生みながら、トータルで病院を支え、それによって病院や地域医療そのものをもっともっと強くしていく。そういう絵を現実的に描けるようになってきたのです。

個人的な話ですが、私が5年前にヘンリーへの入社を決めたのは、ヘンリーという会社が、電子カルテ・レセコンという領域をやり切った先で、社会保障や保険を含めた日本の医療のあり方、そしてお金のあり方を変えられるポテンシャルを持っていると思ったからです。

医療のど真ん中のデータやソリューションを持つ会社になれば、それらを利活用して、より良い社会保障のあり方を模索したり、制度そのものに対して提言していく手段も持ちうる。それは、ソフトウェアエンジニアとして関われる仕事のスケールとして、めちゃくちゃ面白いと思ったのです。

正直に言えば当時の私の認識は相当に甘く、電子カルテ・レセコンという領域は、入社前に想像していたよりもずっと難しかったのですが……。

いまその5年が活きていると感じています。当時からずっとやりたいと思っていた領域に、本当に手を出せるところまで来ることができた。ようやく面白くなってきたというとやや語弊があるかもしれないですが、心からいまがいちばん面白いと思っています。

次のチャレンジ

電カル・レセコンのアセットを掛け算にして、病院の課題を面で解いていく。この本題に事業として向き合うとなると、組織に求められるものも変わります。

私は、一人ひとりが自分の仮説を持って、自律的に意思決定しながら前に進める組織になっていく必要があると考えています。開発速度が上がったことで、少人数で1本の開発ラインを持つことが現実に成立するようになりました。この状態で高密度に思考しながら走れることの強さは、以前とは比較になりません。

これは手放しで喜べる話ではなく、ここ自体が私たちのいちばん大きな組織的チャレンジだと思っています。

  • 目線を揃えることの難しさ
    • 一人ひとりが自律的に仮説を立てて動いた結果、全員がバラバラな方向を向いてしまえば、ヘンリーという会社としての相乗効果は生まれない。
  • 属人化
    • 少人数で動くため、本質的に属人的になりやすい。
  • 働く人の実感
    • 少人数、時には一人で動くということは、孤独になりやすく、成長の機会が得づらかったり成長できている実感を持ちにくい。

これらは、マネジメントとして向き合うべき課題であり、いまもまさに直面している課題です。

一方で、ソフトウェアエンジニアとしてこれまで働いてきた身からすると、これからのソフトウェアエンジニアに求められる目線や経験という意味で言えば、いまのヘンリーはすごく良い場になっているのではないかと思っています。たとえば数人のチームが病院の現場に入り、経営・業務上の課題を見つけ、仮説を立て、既存のアセットを活かしながら数週間で試し、実運用の結果を見ながら提供価値と事業モデルを磨く。そんなやり方を実践していきたいと考えています。

AIを適切に駆使しながら 価値あるものを探し、実現し、顧客と相対しながら、事業として成立させる というまさにフルサイクルなエンジニアとしてのスキル、属人化を防ぐためのAIを前提とした仕組み作りやそれを活用するための言語化能力、新しいソフトウェアエンジニアリングのあり方に対するマネジメントスタイルの確立。どれもこれからの社会において重要になるスキルであり、それを本気で実践できる場、経験できる機会がたくさんある場はそう多くないと思っています。

おわりに

ヘンリーはこれまで、電子カルテとレセコンという病院のど真ん中をやりつづけました。そして、そこを持っていないと解けない課題に、ようやく手を出せるところまで来ました。まだトンネルを抜けたというには早すぎるかもしれませんが、出口は見え、その先の挑戦を見据えて準備するべき段階には明確に入ったと思っています。 組織的にも個々人としても、新しいフェーズでのチャレンジがたくさん待っていますが、それを乗り越え、より大きな成果を出すための入り口に立っています。

大きな社会的意義のある領域で、価値ある事業を自身で作っていくことに少しでも興味を持っていただけた方は、ぜひカジュアルにお話させてください!

jobs.henry.jp

*1:「レセプトコンピュータ」の略。医療機関の収入は患者さんの窓口負担と、保険者に請求する診療報酬から成り立っています。電子カルテが「患者さんに何をしたか」を記録するシステムなのに対し、レセコンは「それが制度上いくらになるか」を計算して請求するシステムです。Henry はこの両方を一体で提供しています。

GitHub Packages (Maven) を Google Artifact Registry へ移行しました

株式会社ヘンリーでSREをしている戸田(id:eller)です。弊社では社内での Maven パッケージの配布に GitHub Packages (Maven) を使っていましたが、先日これを Artifact Registry に移行しました。 この記事では、移行の背景となったサプライチェーン攻撃への問題意識、Artifact Registryを選んだ理由、そして実際に移行して見えた課題を紹介します。

他社の事例から、Classic Personal Access Tokenの運用を見直す

移行を考えるきっかけになったのは、2025年に相次いで報告されたGitHub Actionsのサプライチェーン攻撃です。tj-actions/changed-filesを起点とした事案などではGitHub Actions ワークフローが改ざんされ、ワークフロー内の認証情報が窃取される危険性が示されました。特にワークフローで利用していた Classic Personal Access Token(Classic PAT) が漏えいし、別のリポジトリの侵害に利用されたことに注目しました。

Maven パッケージをエンジニアの手元の開発環境のためにダウンロードするには、Classic PAT を使う必要があります。 GitHub のドキュメントでも、GitHub Packages の認証には Classic PAT を使うものとされています。

しかし Classic PAT は GitHub Organization をまたぐ権限を持つ強力なものです。エンジニアが他の GitHub Organization やリポジトリのために作成した Classic PAT が漏洩した場合ですら、我々のリポジトリにアクセスできる可能性が生まれます。GitHub としても基本的には Fine-grained PAT の利用を推奨していますし、GitHub Organization の管理者としては Classic PAT によるアクセスを禁止することでこのリスクに対応したいと考えました。

しかしClassic PATの利用を組織側で制限するためには、当然ながら GitHub Packages (Maven) の利用を見直す必要がありました。

移行先を Artifact Registry に決めるまで

最初に検討したのは AWS CodeArtifact でした。弊社ではAWSも利用しており、パッケージリポジトリとして必要な機能は揃っていました。

ところが、依存関係の更新に使っているクラウド版 Renovate との組み合わせで課題が見つかりました。 CodeArtifact の認証トークンは最長12時間で失効しますが、クラウド版 Renovate からこのトークンを継続的に更新する現実的な方法を用意できませんでした。Renovate 公式リポジトリの discussions も未解決で、現状きれいな解決方法はないと判断しています。

そこで採用したのが Google Artifact Registry(以下、Artifact Registry)です。Artifact Registry は Gradle 向けの認証ヘルパーを提供しており、Application Default Credentials を利用できます。Renovate についても、特に問題なく運用可能だと判断しました。

二重書き込みで段階的に移行する

まず Maven パッケージを GitHub Packages にデプロイしているリポジトリと、それを利用するリポジトリを棚卸ししました。Gradle ビルドスクリプト、GitHub Actions ワークフロー、Renovate の設定とシークレット、README に記載されているローカル開発の手順などを確認し、パッケージの公開・取得に関わる設定を洗い出しました。

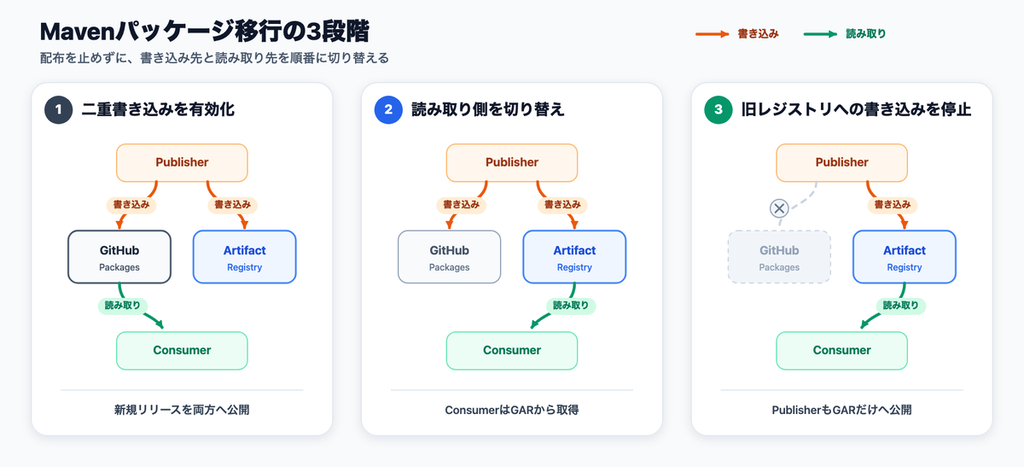
Artifact Registry に Maven リポジトリを作成した後、パッケージをデプロイするリポジトリを変更し、GitHub Packages と Artifact Registry の両方へ同じアーティファクトを公開するようにしました。二重書き込みには移行期間中の構成が複雑になる課題はありますが、公開側と利用側を一斉に切り替えずに済みます。 新しい配布先へ正常に公開できることを確かめてから、各利用リポジトリの Gradle 設定、GitHub Actions の認証、Renovate の設定を順番に変更していきました。 最後にローカル開発手順から GitHub のユーザー名と PAT の設定を削除し、Artifact Registry の認証手順へ置き換えました。

図1 二重書き込みによる段階的な移行

ローカルのpnpm installで見つかった別の依存

Maven パッケージの移行が完了し、Classic PATの利用を制限した後、ある開発者から「ローカルで pnpm install が403になる」と相談がありました。 取得に失敗していたのは、コードフォーマットなどの設定を共有するために GitHub Packages (npm) へ公開していたプライベートnpmパッケージでした。

GitHub Actions ワークフローでは GITHUB_TOKEN を使っていたため、問題なくパッケージを取得できていました。GitHub Packages (npm) は設定によって他のリポジトリからも GITHUB_TOKEN でパッケージをダウンロードできるという点が GitHub Packages (Maven) と異なり、このために Classic PAT を利用していまんでした。

こうした背景のために Classic PAT が運用上必要だという考えが筆者になく、エンジニアが課題に向き合う形となってしまいました。 今回は GitHub CLI の OAuth トークンに read:packages スコープを追加し、そのトークンを pnpm へ渡す手順を回避策としました。

$ gh auth refresh -s read:packages
$ export NPM_TOKEN=$(gh auth token)
$ pnpm install

移行を通じて得られたこと

今回の移行で得られた最大の成果は、Classic PAT の利用を GitHub Organization 全体で禁止できたことです。これによって従業員が別の用途で作成した Classic PAT が漏洩しても、そのトークンを使って弊社 Organization のリポジトリへアクセスされる経路を閉じることができました。 今後も、開発者の使いやすさを損なわない認証手順を整えながら、セキュリティ対策を改善していきます。

個人情報保護法の改正で、医療情報SaaSは患者の同意なしに統計情報を作成可能になるのか

株式会社ヘンリーでVP of Technologyをしております、戸田(id:eller)です。

2026年7月10日に成立した改正個人情報保護法では「統計作成等」にのみ利用される場合について、本人の同意なしに個人データを第三者へ提供できる特例が盛り込まれました。一定のAI開発についても、この特例の対象になり得るとされています。

改正法は7月17日に公布され、原則として公布から2年以内に施行される予定です。具体的な対象範囲や公表事項などは、今後、個人情報保護委員会規則やガイドラインで定められます。したがって、本稿執筆時点では、まだこの特例を利用してデータ提供を開始できる段階ではありません。

この改正は、医療情報システムをSaaSとして提供する弊社のような事業者にとっても、患者本人の同意なしに患者データから統計情報やAIモデルを作成し、利用できるようになるということなのでしょうか?

結論から言えば、改正後も、SaaS事業者が預かった患者データを自由に統計作成やAI学習へ利用できるようになるわけではありません。

今回はこの問題を題材に、個人情報保護法上の「委託」と「第三者提供」の違いや、サービス利用規約、DPA、プライバシーポリシーといった文書が、なぜサービスによる機能提供で重要なのかを考えてみます。多くのバーティカル SaaS では似たような課題を持つかと思いますので「医療機関」「患者情報」などの表現をご自身のドメインの用語に置き換えてみてください。

なお、本稿は法改正の概要と実務上の論点を技術者向けに整理したものであり、個別案件についての法的助言ではありません。

今回の改正で何が変わるのか

現行の個人情報保護法では、病歴などの要配慮個人情報の取得や、個人データの第三者提供には、原則として本人の同意が必要です。

一方、複数の事業者が保有するデータを横断的に分析し、特定の個人との対応関係が排斥された統計情報やAIモデルを作りたいというニーズは高まっています。たとえば、複数の医療機関がそれぞれ保有する患者情報をSaaS事業者に提供し、SaaS事業者がそれらを横断的に分析して、特定の患者との対応関係を持たない統計情報や、統計作成等に当たるAIモデルを作成する場合です。 最終的に作成されるものが個人に関する情報ではないとしても、その作成過程では個人データを別の事業者へ渡す必要があり、ここで本人同意が必要になることがデータ利用上のハードルになっていました。

今回の改正では、個人データが「統計作成等」にのみ利用されることが担保されている場合、本人の同意なしに第三者へ提供できる特例が新設されました。

4月7日の法案閣議決定時点における個人情報保護委員会の説明では、次のような規律が想定されています:

  • 提供元、提供先や、作成しようとする統計情報等の内容を公表する
  • 統計作成等のみを目的とする提供であることについて、提供元と提供先が書面で合意する
  • 提供を受けた事業者による目的外利用を禁止する
  • 提供を受けた個人データのさらなる第三者提供を制限する

また、「統計作成等であると整理できるAI開発等」も対象になり得るとされています。

ただし、AIという名前が付けば何でも対象になるわけではありません。たとえば、多数の症例から集団の傾向を学習し、特定の患者との対応関係を持たない予測モデルを作る場合は、特例の対象となる可能性があると考えられます。一方、患者単位の記録を検索するRAGのデータベース、患者ごとの埋め込みベクトル、学習データを再現できるモデルなどは、単純に「統計作成等」とは整理できない可能性があると考えられます。具体的な対象範囲は、今後の規則・ガイドラインを待つ必要があります。

重要なのは、機械学習という技術を使ったかどうかではなく、何を作るために個人データを扱い、完成物や中間生成物に特定の個人との対応関係が残るかです。

患者情報を扱う主体とそれぞれの役割

今回の特例が医療情報システムSaaSにどのように関係するかを考えるために、まず患者情報を誰が、どのような立場で取り扱っているのかを整理します。

医療情報システムSaaSでは、少なくとも次のような主体が関係します。

  1. データによって識別される患者
  2. 診療のために患者情報を取得する医療機関
  3. 医療機関からデータの保存や処理を受託するSaaS事業者
  4. SaaSの実行基盤を提供するクラウドサービス事業者

患者は、個人情報保護法上の「本人」です。医療機関が保有する保有個人データについて、開示、訂正、利用停止等を求めることができます。

医療機関は、診療という自らの業務を行うために利用目的を定め、患者情報を取得・利用し、その取扱いに責任を負う個人情報取扱事業者です。

医療機関は、患者から直接個人情報を取得する場合、その利用目的を院内掲示等によって明らかにします。また、患者への医療提供に通常必要な範囲の利用については、院内掲示等で利用目的を示し、患者から明確な反対や留保がなければ、黙示の同意が得られているものとして扱われる場合があります。

ただし、院内掲示によって、あらゆる利用について包括的な同意が得られるわけではありません。黙示の同意が認められる範囲は、患者への医療サービスの提供に通常必要であり、医療機関が示した利用目的の範囲に限られます。

医療機関が電子カルテSaaSに患者情報の保存、検索、集計などを行わせる場合、SaaS事業者は、通常、医療機関から個人データの取扱いを委託される立場になります。

SaaS事業者が患者本人から直接データ管理を任されているわけではありません。

SaaS事業者が患者情報を取り扱える範囲は、患者との直接契約の有無ではなく、医療機関から委託された業務と、その業務のために必要な範囲によって決まります。そのため、患者情報を受け取ったことだけを理由に、SaaS事業者が独自の事業目的で利用できるようになるわけではありません。

なお、クラウドサービス事業者の位置付けは、契約と技術構成によって異なります。

クラウドサービス事業者が個人データの内容を閲覧、加工、分析するなどの取扱いを行う構成であれば、再委託先などとして整理する必要があります。一方、クラウドサービス事業者にはサーバーやストレージ等の情報処理基盤だけを提供させ、契約上も技術上も保存された個人データを取り扱わない構成であれば、個人情報保護法上の「提供」や「個人データの取扱いの委託」には当たらない場合があります。この場合でも、SaaS事業者は自らの安全管理措置として、クラウドサービスの安全性を適切に評価・管理する必要があります。

このように、医療機関、SaaS事業者、クラウドサービス事業者は、それぞれ同じ患者情報に関係していても、個人情報保護法上の立場と、許される取扱いの範囲が異なります。特に重要なのが、医療機関からSaaS事業者へのデータ提供が、「委託」なのか「第三者提供」なのかという違いです。

委託と第三者提供の違い

医療機関がSaaS事業者に患者情報を渡す場合、一般には「第三者提供」ではなく「委託」として整理されます。

形式的に見れば、医療機関とは別の法人であるSaaS事業者にデータを渡しているため、SaaS事業者は第三者です。しかし、医療機関の利用目的を達成するために必要な範囲でデータ処理を委託する場合、個人情報保護法上、その委託先は第三者提供規制における「第三者」に該当しないものとして扱われます。

これは、委託先が本人との関係では委託元と一体のものとして扱われることに合理性があるためです。具体的には経済産業省の出しているフローチャートなどをご確認ください。

flowchart TD
    A[患者]
    B[医療機関]
    C[SaaS事業者]

    A -->|個人情報の提供| B
    B -->|利用目的の達成に必要な範囲での委託| C

委託であれば、医療機関からSaaS事業者へのデータ提供について、第三者提供として患者本人の同意を取得する必要はありません。

その代わり、SaaS事業者がデータを取り扱える範囲は、委託された業務の範囲に限定されます。個人情報保護委員会のガイドラインも、委託先は委託された業務以外に個人データを取り扱えないとしています。

一方、SaaS事業者が医療機関から受け取ったデータを、医療機関の利用目的とは別の自社目的で利用する場合は、単純な委託とはいえません。

個人情報保護委員会は、委託先がデータを統計情報へ加工すること自体は、委託業務に含まれていれば可能としています。しかし、委託業務の範囲外で統計情報を作成し、それを委託先自身のために利用することはできないとも説明しています。

例えば、A病院から委託を受け、A病院の病床稼働率を集計してA病院に返す処理は、比較的素直に委託として整理できます。

これに対して、A病院から受け取った患者データを、SaaS事業者が独自に開発する別製品や、顧客以外にも提供する分析サービスへ利用する場合は、通常の委託から外れる可能性が高くなります。

経済産業省のAIの利用・開発に関する契約チェックリストでも、AIサービスの提供者へ個人データを渡す際には、まずデータが実際に提供されるか、提供が委託などの第三者提供の例外に当たるか、国内外のどの事業者が取り扱うかという順序で確認する必要があると整理されています。

したがって、医療機関との契約に患者データの利用を認める条項を置いただけで、SaaS事業者が委託データを自由に二次利用できるわけではありません。契約は必要ですが、契約だけで適法になるわけではなく、医療機関側の利用目的や、個人情報保護法上の提供根拠と整合している必要があります。

3つの利用方法を考える

具体的な利用方法を、次の3つに分けて考えてみます。

1. 特定の医療機関のデータから統計を作成し、その医療機関に返す

例えば、ある医療機関のデータから、次のような情報を作成する場合です。

  • 診療科別の患者数
  • 病床稼働率
  • 平均在院日数
  • 算定漏れの傾向
  • 時間帯別の受付件数
  • 医療機関内の業務量の予測

これらが医療機関へ提供するサービスの一部として定められていれば、従来から委託業務として実施できる可能性があります。今回の改正によって、初めて可能になったわけではありません。

ただし、ある条件に該当する患者が1人しかいない場合など、統計から患者を推測できることがあります。医療機関内では患者の背景情報を知っている人も多いため、少数セルの抑制など、出力結果に応じた対策が必要になるかもしれません。

2. 全医療機関のデータから統計やモデルを作成し、製品機能に活用する

例えば、複数の医療機関から提供を受けた患者データを用いて、次のような統計やモデルを作成する場合です。

  • レセプトチェックの精度向上
  • 疾患や診療行為の一般的な傾向分析
  • 病床需要の予測モデル
  • 医療機関間のベンチマーク
  • 文書分類や入力補助のための機械学習モデル

これは、従来から常に不可能だったわけではありません。

個人情報保護委員会は、委託元の利用目的の達成に必要な範囲内であれば、委託先が自社の分析技術を改善するために委託データを利用できる場合があるとしています。

例えば、医療機関から委託されたレセプトチェックを適切に行うため、その分析技術を改善することが委託業務の一環として明確に位置付けられていれば、委託として整理できる余地があります。

一方で、全テナントの患者データを用いて共通の統計やモデルを作成し、その完成物を将来の顧客や別の製品にも活用する場合、各医療機関の利用目的の達成に必要な範囲を超え、SaaS事業者独自の目的が含まれる可能性があります。

その場合、改正後は、通常の委託とは別に、今回新設される「統計作成等」の特例に基づく第三者提供として構成できる可能性があります。

この構成では、医療機関とSaaS事業者との間で「統計作成等」だけを目的とすることを書面で合意し、提供元、提供先、作成内容等を公表し、目的外利用を防止する必要があります。

ただし、この特例によって利用できるのは、統計作成等に必要な範囲の患者データです。

患者データそのものや、その複製・加工物を、製品提供や別の事業目的に自由に利用できるようになるわけではありません。

製品機能に活用できるのは、特例の要件を満たして作成された統計やモデルです。

つまり、製品の機械学習機能だから委託であり、利用規約に記載すれば使えるという単純な話ではありません。

3. 全医療機関のデータから統計を作成し、政策提言や製品外の活動に活用する

例えば、複数の医療機関から提供を受けた患者データを用いて、地域医療の提供体制、医療従事者の業務負荷、診療報酬制度上の課題に関する統計を作成し、その統計を政策提言や業界活動に活用する場合です。

これは通常、個々の医療機関に対する電子カルテサービスの提供という委託目的からは離れます。

現行法でも、医療機関から明示的にその分析業務を委託されている場合や、適法に匿名加工情報を作成して提供する場合など、実現方法が全く存在しなかったわけではありません。しかし、SaaS事業者が通常のサービス提供の過程で預かった患者データを、自らの判断で政策利用へ転用することはできません。

改正後は、政策提言や業界活動に用いる統計を作成するために、「統計作成等」の特例を利用できる可能性があります。

ただし、この特例は、政策提言そのものを目的として患者データを利用することを許すものではありません。

患者データを扱えるのは、あらかじめ公表・合意した統計作成等に必要な範囲です。

政策提言や業界活動には、その過程で作成された統計を用います。

ただし、患者が特定できないことだけでは十分ではありません。特定の医療機関の経営状態、診療傾向、事故率などが推測できる場合には、個人情報保護法とは別に、契約上の秘密保持や医療機関の信用、適切な比較表示などが問題になります。

したがって、この用途では、法令上の最低限の公表や合意に加え、次のようなガバナンスも必要になるでしょう。

  • 参加する医療機関を明示的に募る
  • 利用するデータ項目と分析目的を具体的に説明する
  • 医療機関や地域を推定できる情報を抑制する
  • 公開前に分析方法や表現をレビューする
  • 分析の限界やデータの偏りを明示する
  • 当初説明した目的から変更する場合は、改めて合意する

本人同意が不要になっても、患者への説明や公表が不要になるわけではない

今回の改正で不要になるのは、一定の条件を満たす場合の「患者本人からの個別の同意」です。 本人への説明、利用目的の明確化、医療機関とSaaS事業者との合意が不要になるわけではありません。

むしろ今回の特例では「統計作成等」だけに利用されることを担保するために、提供元と提供先の名称、作成する統計情報等の内容などを公表し、提供元と提供先が書面で合意することが求められます。

また、医療・介護分野のガイダンスは、患者にとって利用目的が明らかである場合についても、患者に利用目的を分かりやすく示す観点から、院内掲示等によって公表することを求めています。

そのため、医療機関が新しい特例を使ってSaaS事業者へデータを提供する場合には、法令上の公表事項だけではなく、患者向けの院内掲示やプライバシー通知についても見直すことが望ましいでしょう。

少なくとも患者から見て、

  • どのようなデータが利用されるのか
  • 誰に提供されるのか
  • 何を作るために利用されるのか
  • 作成された統計やモデルがどのように使われるのか
  • 個人を特定したり、個人に働きかけたりするためには使われないのか

が理解できる説明が必要です。

本人同意を取得しない制度だからこそ、透明性の重要性はむしろ高くなります。

利用規約、DPA、プライバシーポリシーはそれぞれ役割が異なる

ではこうした個人情報の取扱いについては、SaaSの利用規約やSaaS事業者のプライバシーポリシーに何か書いて良いのでしょうか?

こうした文書は、異なる相手に対して異なる事項を説明・合意するものなので、その違いをまず踏まえる必要があります:

文書 主な役割
医療機関の院内掲示・患者向けプライバシー通知 患者に利用目的や提供先、利用方法を説明する
サービス利用契約・利用規約 医療機関とSaaS事業者のサービス上の権利義務を定める
DPA・個人データ取扱特約 委託する処理、目的、安全管理、再委託、削除、監査等を定める
SaaS事業者のプライバシーポリシー SaaS事業者自身が取得・利用する個人情報の取扱いを公表する

特に注意が必要なのは、SaaS事業者のプライバシーポリシーに、

個人を特定できない統計情報を作成し、利用することがあります

と記載するだけでは、医療機関から委託された患者データを全テナント横断で利用できるようにはならないということです。

プライバシーポリシーは、医療機関の利用目的を変更するものでも、医療機関とSaaS事業者との委託契約の範囲を拡張するものでもありません。

まず、何のために、どのデータを使い、どのような統計やモデルを作りたいのかを具体化する必要があります。

そのうえで、

  • 医療機関の利用目的と委託範囲内の処理なのか
  • 改正法の特例に基づく第三者提供として扱うのか
  • 患者、医療機関、SaaS事業者にどのように説明するのか
  • 元データ、中間生成物、完成したモデルをいつまで保存するのか
  • 目的外利用や再識別をどのように防止するのか

を整理し、実際の処理内容と契約文書を一致させる必要があります。機能を実装してから法務文書を整えるのでは順序が逆だということです。 サービス仕様を決めること、データフローを設計すること、契約を整備することは、本来、ひとつのプロダクト設計として並行して行われるべきものです。

まとめ

今回の個人情報保護法の改正は、医療情報システムをSaaSとして提供する事業者が、患者の同意なしに、預かった患者データを自由に統計作成やAI学習へ転用できるようにするものではありません。

医療機関は、患者から情報の管理を委託されているだけの存在ではなく、自ら利用目的を定めて患者情報を取り扱い、その取扱いに責任を負っています。

SaaS事業者が医療機関から受け取った患者データを取り扱えるのは、原則として、医療機関の利用目的の達成に必要な委託業務の範囲内です。そのため、

  • 特定の医療機関向けに統計を作成して返す
  • 全医療機関のデータから共通の製品機能やAIモデルを作る
  • 全医療機関のデータから政策・研究用の統計を作る

という3つの利用方法は、それぞれ異なる法的・契約上の整理を必要とします。

改正後は、委託範囲外となる統計作成や一定のAI開発についても、本人同意なしの第三者提供という新しい経路を利用できる可能性があります。

しかし、そのためには「統計作成等」だけに利用することを明確にし、医療機関とSaaS事業者との間で合意し、作成内容を公表し、目的外利用を防ぐ必要があります。

本人同意が不要になることと、データ利用について誰にも説明しなくてよくなることは、全く異なります。

統計情報やAIモデルをサービスへ活用したいと考えたとき、最初に必要なのはモデルの選定や実装ではありません。

何のために、どのような情報を作りたいのか。そのために患者情報をどのように取り扱い、患者や医療機関にどう説明するのかを決めることです。 サービス利用規約やDPA、プライバシーポリシーといった文書は、サービスがデータをどのように扱うのかを、顧客や患者との関係の中で定義する、プロダクトそのものの一部なのだと考えます。

医療現場のリスク評価を、QAに活かすという視点

はじめに

ヘンリーでQAとして働くflukaです。前職は、急性期病院の医療事務として18年。入院係としてDPC会計やレセプト業務を担当し、病棟で患者さんや医療スタッフのすぐそばで仕事をしてきました。

そんな私が、いまソフトウェアQAをしています。

医療系のSaaSをQAしていると、「この変更は軽いのか、それとも重いのか」という判断に迷う場面がよくあります。

ヘンリーでもリリース数が増えるなかで、QAのリソースが追いつかなくなる場面が増えてきました。「軽い変更ならエンジニアだけで品質を担保できる仕組みがあれば、QAは本当に必要なところに集中できる」——そう考えて、社内ではQA要否をAIで判定する仕組みを試行錯誤しながら育てています。

ただ、運用してみると、現場感覚と合わない判定が出てくることがあります。

そのきっかけのひとつが、処方箋様式の改訂対応でした。変更内容としては「文言を追加するだけ」に見える。でも、医療事務出身の自分の感覚としては「これ、軽い変更じゃないかも」という違和感があったのです。

このギャップを、ドメイン知識のない人とも共有できる指標として翻訳できないか。そう考えたときに思い出したのが、医療現場で長年使われてきたリスク評価の考え方でした。

この記事は、医療業界の知見を、ソフトウェアQAの実務にどう持ち込めるかを整理したものです。同じような領域に関わる方の参考になれば嬉しいです。

QAは「変更内容」で測られがち

ソフトウェアのQA要否判定では、一般的にこんな観点で測ります。

  • どの領域を変えたか(医療安全 / 金銭 / 帳票 / UI など)
  • 何を変えたか(ロジック / API / 文言 / 見た目 など)
  • どこまで影響するか(全顧客 / 一部顧客 / 社内のみ)
  • テストでカバーされているか
  • 他機能への波及はあるか

これらに点数をつけて、閾値で「QA必須 / 任意 / 不要」を判定する仕組みです。

理論的にはよくできた設計です。ただ実際に過去の案件で試してみると、現場感覚と合わない判定が出てくることに気づきます。

その違和感の正体を、医療業界の知見と照らし合わせて考えてみます。

医療現場のリスク評価:インシデントレベル

医療現場には、インシデントレベルという標準的なリスク評価軸があります。

レベル 状態(患者への影響度)
0 エラーが起きたが、患者に実施される前に発見
1 患者に実施されたが、実害なし
2 観察強化や検査が必要になった
3a 簡単な処置や治療が必要になった
3b 濃厚な処置や治療が必要になった
4a 永続的な障害が残ったが、機能障害や美容上の問題は伴わない
4b 永続的な障害が残り、有意な機能障害や美容上の問題を伴う
5 死亡

出典:国立大学附属病院医療安全管理協議会「インシデントの影響度分類」

日本の多くの病院で使われている分類です。医療現場の人間がインシデントレポートを書くときに使う標準的な軸でもあります。

この評価の特徴は、「何が起きたか」ではなく、「患者にどんな影響があったか(結果)」で測ることです。

処方箋の改訂を例に、考えてみる

具体的な例で考えます。

題材は処方箋様式の改訂対応。たとえば「リフィルの説明文を処方箋に追加する」という変更を想定します。

1. 変更内容ベースで測ると

  • 領域:帳票・出力物として中程度の重み
  • 変更性質:文言追加 → 軽い
  • 影響範囲:全顧客 → 重い
  • 波及先:他帳票への影響 → 中程度

これらを合算すると、中程度のスコア(QA任意)に落ち着きます。

「文言を追加しただけ」と捉えられるためです。

2. 結果ベース(患者影響)で測ると

もし不具合が起きたら、患者にどんな影響が出るか?(QA・テスト工学で 影響度(Severity) と呼ばれる視点です)

  • 文言の誤字・脱字 → レベル0〜1(読めるけど違和感)
  • 説明文の内容が間違っている(リフィル回数の誤記など) → レベル2〜3(運用ミスにつながる)
  • 文言追加の影響で薬名・用量が見切れる → レベル4〜5(見落としによる誤投与のリスク)
  • リフィル可否の表示ロジック誤り → レベル3〜5(誤ったリフィル運用につながる可能性)

※レベルは筆者による例示です。

医療業界や医療機器のリスクマネジメント(ISO 14971 など)では、「起きうる最悪のケース」で評価するのが基本です。希望的観測でリスクを過小評価しないための原則です。

同じ案件でも、軸を変えると判定が変わる

判定の軸 判定結果
変更内容ベース 中程度 → QA任意
結果ベース(最悪ケース) レベル4〜5 → QA必須

「文言を追加した」という事実だけ見れば軽い変更です。

でも処方箋という書類は、書かれているもの自体が患者の体に直接影響する。

ここに、変更内容ベースの軸だけでは捉えきれない盲点があります。

「帳票」か「医療情報」か

このギャップが生まれる根本には、領域分類の粒度の問題があります。

技術的には、処方箋は「帳票・出力物」です。PDFを生成して印刷する書類。だから判定システムでは「帳票」のカテゴリに入ります。

でも、書類の中身は薬の指示そのものです。薬局はこれをもとに調剤し、その内容が患者の服薬につながります。

つまり、

  • 書類の見た目 = 帳票
  • 書類の中身 = 医療情報そのもの

同じことが、診断書・カルテ出力・看護記録・退院サマリーにも当てはまります。

これらは「帳票」というカテゴリでひとくくりにされがちですが、中身の医療性は領域ごとに大きく違います。

2つの軸を組み合わせる

技術的な変更内容を測ることは大事です。それは客観性があり、再現可能です。

一方で、結果(患者影響)ベースの評価は、変更内容では捉えられないリスクを可視化します。

変更内容ベース 結果ベース(患者影響)
視点 何を変えたか 起きたら何が起きるか
強み 客観的・再現可能 患者影響を直接捉える
弱み 中身の重みが見えにくい 主観に左右されやすい

変更内容ベース(エンジニア的な客観性)と、結果ベース(医療現場の安全性の視点)。両方の軸を組み合わせることで、より確実なQA判定ができる。これが今回の論点です。

ドメインを知っている人の感覚を、テスト設計や品質基準の言葉に翻訳して持ち込む。医療系プロダクトのQAでは、そうした橋渡しが品質保証の重要な役割のひとつだと感じています。

まとめると

伝えたかったのは、この3つです。

  1. 医療現場には「インシデントレベル」でリスクを測る確立された軸がある
  2. 同じ案件でも、起きうる結果次第でリスクは大きく変わる
  3. 処方箋のような帳票でも、中身は医療情報そのもの

医療系SaaSのQAでは、「この変更は軽いのか重いのか」という判断に迷う場面が多くあります。

そんなときに、「もし不具合が起きたら、患者にどんな影響が出るか」と問い直す視点があると、判断の精度が上がります。

医療業界には、長年積み上げられた患者安全のフレームワークがあります。それをソフトウェアQAに取り入れていく余地は大きいと考えています。

おわりに

QAという仕事は、技術と現場の橋渡しでもあると思っています。

医療現場で培われた知見を、テスト設計や品質基準の言葉に翻訳して持ち込む。医療系プロダクトのQAでは、そうしたドメイン知識が品質保証の重要な支えになっていると感じています。

医療業界の知見をQAに活かす道筋を、これからも探っていきたいと思います。

参考

  • 国立大学附属病院医療安全管理協議会「インシデントの影響度分類」
    1. Kohn et al., To Err Is Human: Building a Safer Health System (1999)
  • ISO 14971:2019(医療機器のリスクマネジメント国際規格)

SRE NEXT 2026 に参加しました

ヘンリーで SRE をやっている id:nabeop です。7/10 と 7/11 に開催された SRE NEXT 2026 は一日中 SRE にどっぷり浸れました。

ヘンリーでは SRE NEXT 2026 にゴールドスポンサーとして参加し、ブースやスポンサー登壇で様々な人と触れ合えた2日間でした。素晴らしいイベントを企画運営していただいた運営スタッフのみなさん、ありがとうございました!!

当日は多くの方にブースに立ち寄っていだきました!

続きを読む

AIにPull RequestのApprove権限を与えて数ヶ月、どのような効果があったか

株式会社ヘンリーでソフトウェアエンジニアをしているwarabi(@warabi1062)です。

ヘンリーでは今年の1月から、一部のPull RequestでAIがレビューをする際にApproveを出す権限も与えています。

今回はAIにApproveを出させるようにした経緯や、約半年間の運用をしてみてどのような効果があったかをまとめます。

AI活用による実装速度の向上

今年の1月頃から、ヘンリーではClaudeCodeをより効果的に活用して実装の全自動化に力を入れてきました。その成果の一部として、IssueのIDを渡すだけで設計、実装、PR作成までをClaudeCodeが自動で行ってくれるSkillの作成などが挙げられます。

Claude Codeで開発を全自動化する - Orchestrator型Skillの設計と実践 - 株式会社ヘンリー エンジニアブログ

このような成果から1月を転換点として実装の作業は早くなりましたが、その結果としてレビュー対象であるPull Requestの数も増え、レビューコストが高くなるという課題が早々に見えてきました。

レビューコストはAI活用が進むほどに大きな問題となることは目に見えて分かっていたため、早めに解決する必要があると考えました。

Approve自動化

レビューコスト増加の対策として、今回はAIがPull RequestをレビューしてApproveも出す環境を目指しました。

ヘンリーではSkill活用による実装の自動化以前から、CursorやClaudeCodeによるPull Requestレビュー自体は行っていました。ただしこれはレビューコメントを投稿するのみで、Pull Request自体にApproveまでは出さない状態です。コードの品質が高くてもコメントで「Approveです!」と投稿するまでの動きになります。

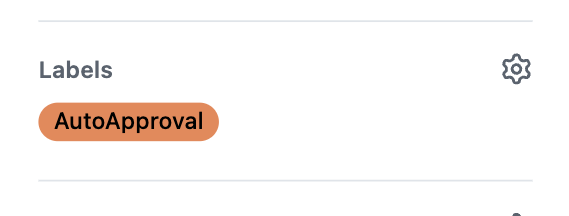
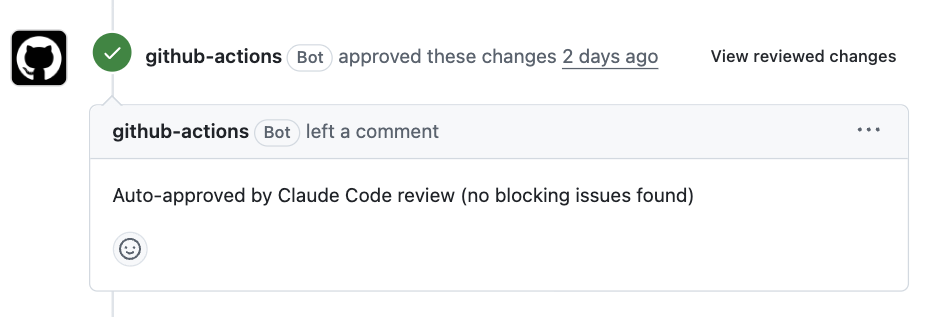
そこでこのAIレビューのワークフローを調整。Pull RequestにAutoApprovalというラベルを付けていた場合、AIのレビュー結果を元に追加でApproveを出すようにしました。

AutoApprovalラベル

Approve

全てのPull RequestでApprove権限を与えるのではなくラベルを付ける運用にした理由は、人間によるレビューを必須にする余地を残すためです。

このAutoApprovalはバグ修正や簡単な機能追加など、実装難度が低いPull Requestで使う想定のものです。

テーブル定義更新のような破壊的変更を伴うPull Requestや、複雑な実装を伴うPull Requestはラベルを付けずに引き続き人間のレビューを必須とできるようにしています。

どのPull Requestにラベルを付けるかの判断は、Pull Requestの作者に委ねる方針にしています。

組織への展開と性善説運用

AIによるApproveの仕組み自体は整いましたが、これを組織全体にすぐ展開することは危険です。この仕組みを利用する人は、生成コードやレビューについてAIに責任は無くあくまで人間に責任があることを理解しなければなりません。

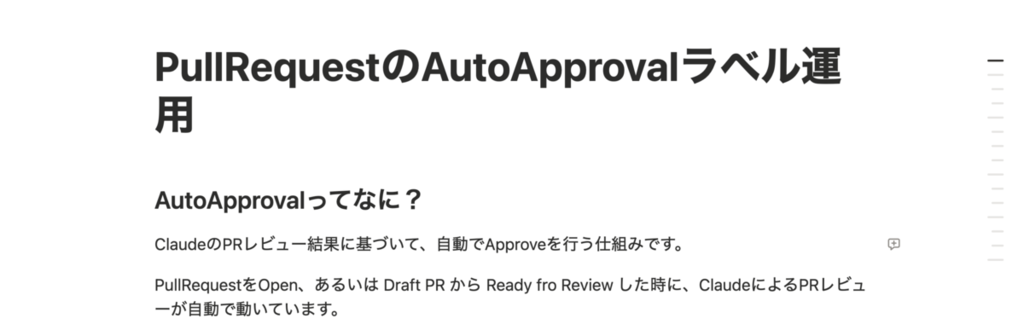
そこで組織にAutoApprovalを展開するにあたり、AIにApproveさせるとはどういうことかを合わせてNotionに整理して伝えることとしました。

Notionページ

ドキュメントでは以下の2点を理解してもらうことを特に重視しました。

  • AIのレビューは完璧ではない
  • AIに責任は無い。最終的なコードの責任が人間にあることは今までと変わらない

ドキュメントを見てもらうことで、マージするコードの責任をあくまで人間(個人やチーム)にあることは変わらないことを了承してもらい、それを利用するかはあくまで各自に任せる性善説運用。導入のハードル自体は上げずに安全に活用してもらうため、このような手順を踏むようにしました。

AutoApproval導入後の状況

AutoApprovalを展開し簡単なPRはAIによってレビューを済ませることで、レビューを遅らせることなく実装のスピードとの両立が行えるようになりました。

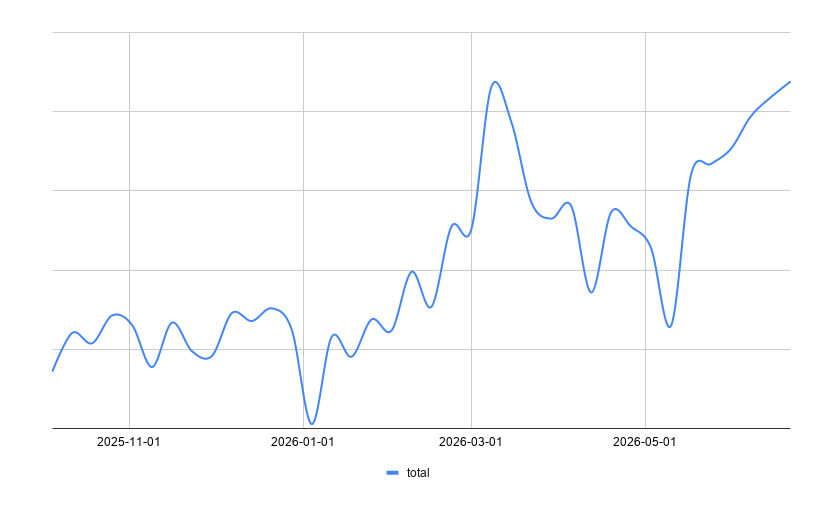
AI活用による影響を確認するため、ヘンリーの主要リポジトリについて約半年間のPull Requestのデータを抽出してみます。

全体のPull Request作成数としては、1月のターニングポイント以前と以降を比較すると約2倍の数値となっています。

PullRequest総数

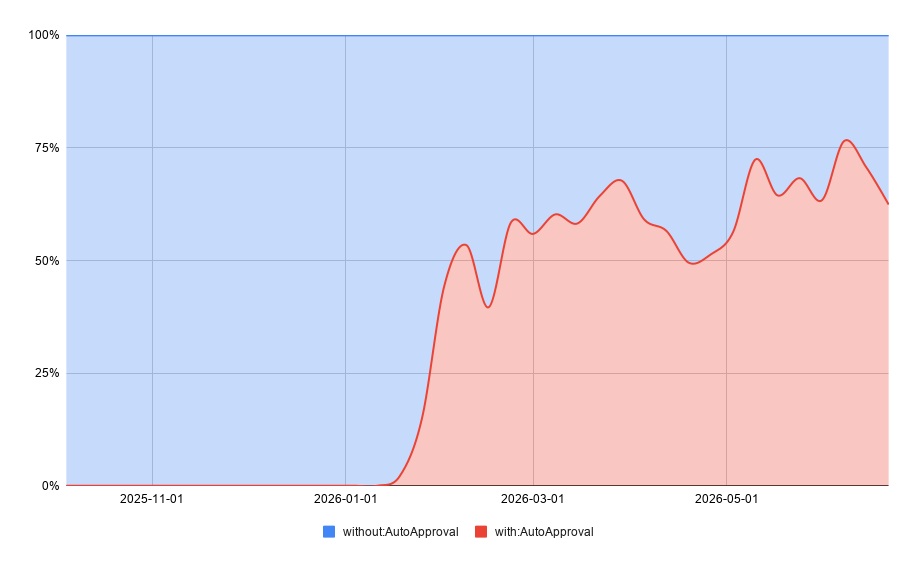
またAutoApprovalラベル有りとラベル無しのPRの数も比較してみました。

AutoApprovalは導入後から広く活用されるようになりましたが、意外だったことはラベル無し( = 人間のレビューが必須)のPull Requestが約50%あり想像よりも多かった点です。

ラベル有無によるPR数

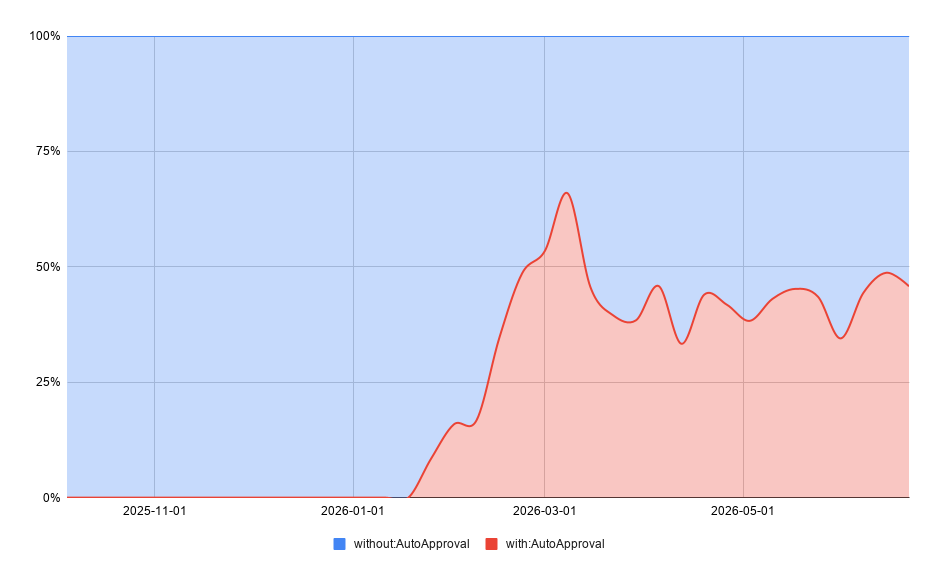
AutoApprovalの利用についてバックエンド・フロントエンドそれぞれの割合も見てみました。

フロントエンド AutoApproval利用割合
バックエンド AutoApproval利用割合

フロントエンドでは約70%のPull RequestでAutoApprovalが、バックエンドでは約40%のPull RequestでAutoApprovalが使われている状況でした。 この差はバックエンドについてはテーブル定義などもあり、破壊的変更が起きやすいためより慎重なレビューが求められるためと考えられます。

これらの数値から、すべてのPull RequestでAutoApprovalが使われるような乱暴な利用状況にはなっていなく、人間が見るべきPull Requestは引き続き人間が見るよう線引きが行われていることが読み取れます。

ヒヤリハットと安全策

事前に予想できていたことではありますが、AutoApprovalによる影響は良い側面だけではありません。AutoApprovalを使った安易なマージを要因としたヒヤリハットは一定発生しうる問題でした。

このような問題は発覚後に都度対応を検討し、これまで以下のような改善を積み重ねてきました。

  • mainなどリリースに影響するブランチへのPull RequestではAutoApprovalを使えなくする
  • サイレントにPull Requestが作成・即マージされることがないよう、メンバーがPullRequestの存在には気付けるよう通知周りの整備をする。
  • linter など 各種設定ファイルの見直し

AutoApprovalの展開後もブラッシュアップを続け、より使い勝手の良い安全な環境を目指そうと取り組んでいます。

AIレビューの品質について

またヒヤリハット以外にもレビュー品質についても課題が残っています。 AIによるレビューの品質は利用するAIモデルの性能やプロンプトに左右されやすく、現状だと複雑な指摘に関してはまだ人間によるレビューに軍配が上がる印象があります。

テストの不足や、潜在的な問題を含んでいるコードをAIが緩い判定でApproveする点は未だ解決しきれていない課題の1つです。

この課題に関してはレビュー用プロンプトやClaude.mdの整備などの改善も行っていますが、モデル選択による影響が大きいとも感じています。Pull Requestの規模や領域に応じてモデルを切り替えるような仕組みの検討も今後行いたいと考えています。

まとめ

今回はAI活用によるPull Request数増加にともなうレビューコスト増加の対策として、AIによる自動Approveの取り組みを行い、実装スピードとレビューコストの両立を目指しました。

ヒヤリハットやレビュー品質といった課題がいくつか残っていますが、AIにより働き方自体が大きく変わっていく流れに適応するべく今回の仕組みを導入することは必要な流れでした。

AI活用によって生じた新しい問題をさらにAIによって解決する。この繰り返しによって働き方を引き続きアップデートしていこうと思います。